- 结果文件
- 使用指南
- 版本记录
- 联系客服
PCycDB(磷循环数据库)是一个经人工校验的生物信息学资源与处理工具集,用于从宏基因组和宏转录组测序数据中鉴定并定量磷循环基因。该数据库涵盖跨越 10 种代谢过程的 138 个基因家族,并引入了同源基因以抑制假阳性检出。至关重要的是,数据库还包含了编码胞内磷代谢过程的基因——使研究人员不仅能探究地球化学磷循环,还能宏观探究微生物磷代谢。
输入文件:
基因组/宏基因组预组装结果文件或包含所有待分析基因组的zip压缩包。
小工具结果:
anno_result_full.csv
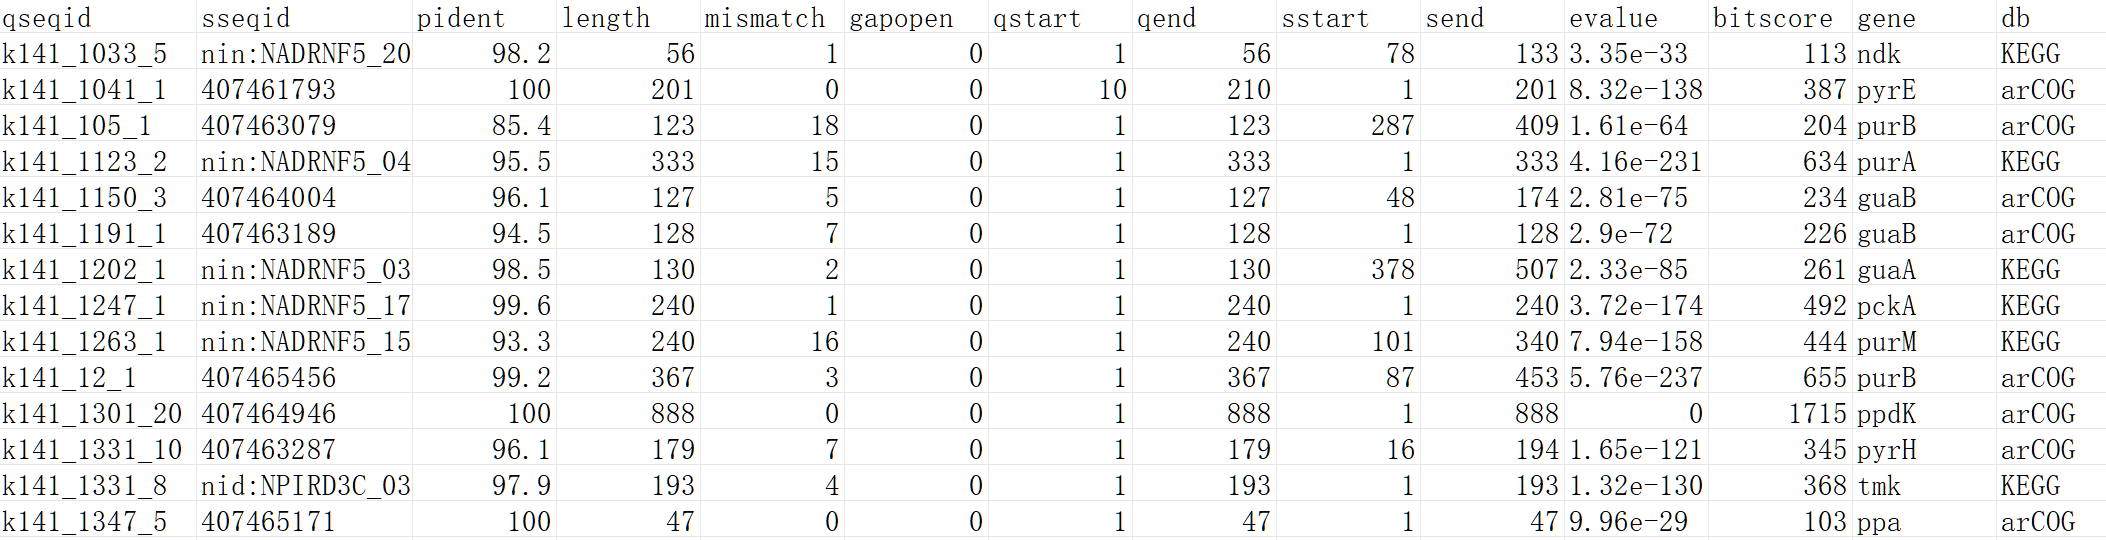
qseqid:Query sequence ID,输入的基因编号(一个基因可以参与多个循环过程);sseqid:Subject sequence ID,比对上的 CCycDB 参考序列 ID;pident:一致性百分比(% identity);length:比对长度(对齐的氨基酸/碱基个数);mismatch:错配数;gapopen:gap数;qstart:查询序列比对起始位置;qend:查询序列比对结束位置;sstart:参考序列比对起始位置;send:参考序列比对结束位置;evalue:期望值,越小越显著(通常 < 1e-5 算可靠);bitscore:比特分值,越高代表匹配质量越好;gene:基因简称;db:该注释来源的原始数据库。
anno_result.csv
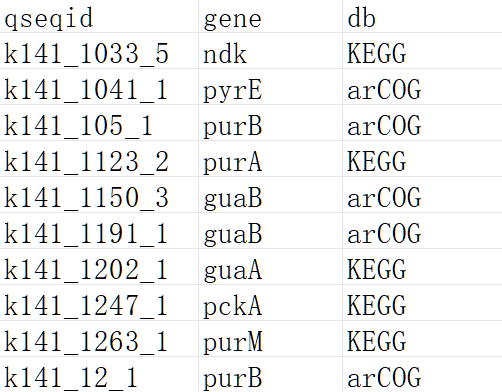
qseqid:Query sequence ID,输入的基因编号(一个基因可以参与多个碳循环过程);gene:基因简称;db:该注释来源的原始数据库。
gene_count_pathway.csv
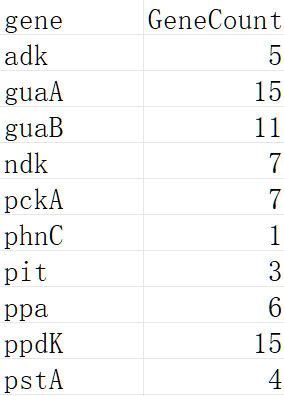
gene:基因简称;GeneCount:注释到该基因的序列数量。
参考文献:
Zeng J, Tu Q, Yu X, et al. PCycDB: a comprehensive and accurate database for fast analysis of phosphorus cycling genes. Microbiome, 2022, 10(1): 1–16.
数据库版本:PCycDBv1.1