- 结果文件
- 使用指南
- 版本记录
- 联系客服
NCyc 是一个精心整理的整合数据库与分析流程,用于对氮(N)循环基因进行快速且准确的宏基因组分析。氮循环是地球生态系统中最重要的大型生物地球化学循环之一,NCyc 使研究人员能够从鸟枪法宏基因组数据中表征各种生态系统内的氮循环通路。该数据库聚合了来自 UniProt、KEGG、COG、eggNOG 和 SEED 等多个公共仓库的蛋白质序列,涵盖跨越八个氮循环过程的 68 个基因(亚)家族。
NCyc 中的蛋白质序列抽自五个公共数据库,随后进行了审校与聚类:
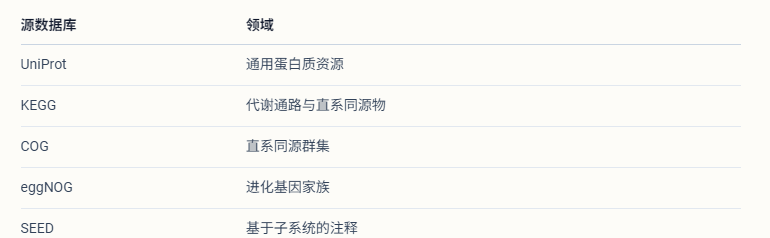
这种多源抽取策略确保了对八个氮循环过程(例如:固氮、硝化、反硝化、厌氧氨氧化、同化/异化硝酸盐还原、氨化作用以及铵转运)的广泛覆盖。每条抽取的序列在纳入前均会根据 NCyc 基因家族定义进行验证。
输入文件:
基因组/宏基因组预组装结果文件或包含所有待分析基因组的zip压缩包。
小工具结果:
anno_result_full.csv
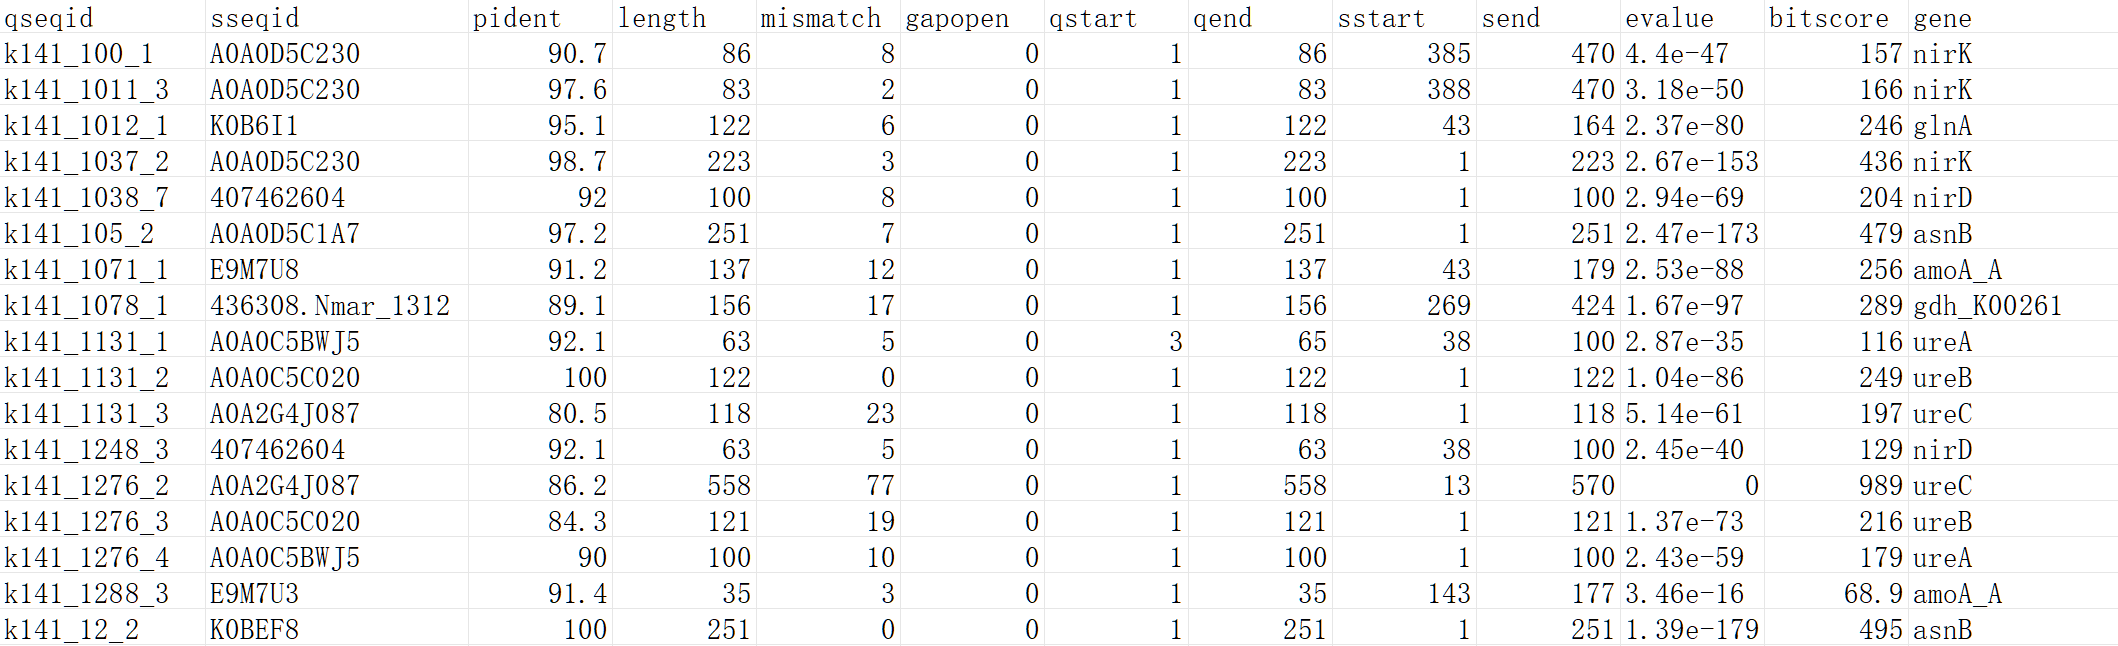
qseqid:Query sequence ID,输入的基因编号(一个基因可以参与多个循环过程);sseqid:Subject sequence ID,比对上的 CCycDB 参考序列 ID;pident:一致性百分比(% identity);length:比对长度(对齐的氨基酸/碱基个数);mismatch:错配数;gapopen:gap数;qstart:查询序列比对起始位置;qend:查询序列比对结束位置;sstart:参考序列比对起始位置;send:参考序列比对结束位置;evalue:期望值,越小越显著(通常 < 1e-5 算可靠);bitscore:比特分值,越高代表匹配质量越好;gene:基因简称。
anno_result.csv
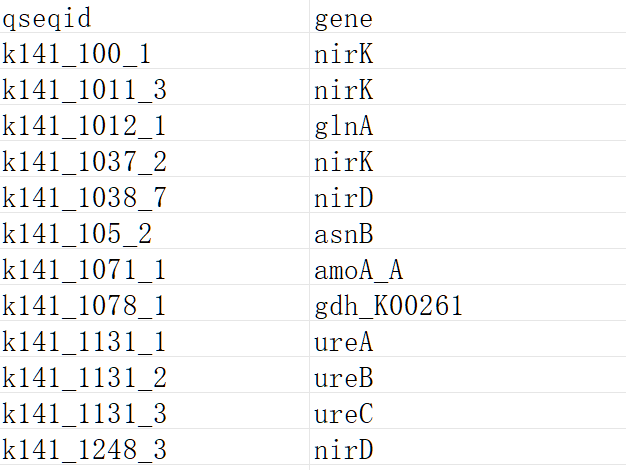
qseqid:Query sequence ID,输入的基因编号(一个基因可以参与多个碳循环过程);gene:基因简称。
gene_count_pathway.csv
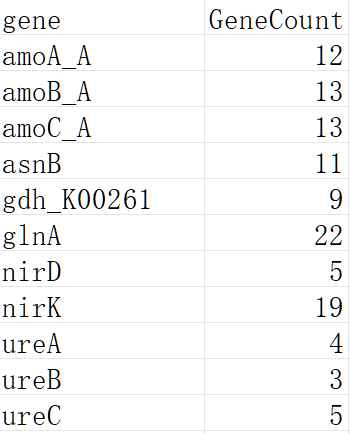
gene:基因简称;GeneCount:注释到该基因的序列数量。
参考文献:
Qichao Tu, Lu Lin, Lei Cheng, Ye Deng, Zhili He, NCycDB: a curated integrative database for fast and accurate metagenomic profiling of nitrogen cycling genes, Bioinformatics, Volume 35, Issue 6, 15 March 2019, Pages 1040–1048, https://doi.org/10.1093/bioinformatics/bty741
数据库版本:NCyc_100_2019Jul