- 结果文件
- 使用指南
- 版本记录
- 联系客服
CCycDB 是一个基于知识的功基因数据库,旨在对微生物碳循环过程进行准确的宏基因组谱分析。它收录了 4,676 个基因家族,按照 6 个顶层分类、45 个子分类 (Level I) 和 188 个子分类 (Level II) 进行组织——与通用的直系同源数据库相比,提供了更具针对性的覆盖范围。一系列验证表明,在对真实宏基因组数据集中的碳循环微生物群落进行谱分析时,CCycDB 在覆盖率、特异性和准确性方面均优于大型公共直系同源数据库。
CCycDB 解决了什么问题?
传统的功能注释流程(例如基于 KEGG、eggNOG 或 MetaCyc 构建的流程)在所有微生物代谢网络中撒下了过大的网。当你的研究问题具体针对碳循环——即碳如何被固定、释放、生物合成、降解或转化——时,这些通用数据库会引入无关通路的噪音,并且会遗漏超出其范围的专业基因。CCycDB 通过提供一个经过精心筛选、以碳为中心的参考数据库,并搭配一个简化的注释流程 (CCycdb.pl) 来解决此问题;该流程只需一条命令,即可从原始宏基因组序列直达通路级别的碳循环谱。
六大碳循环分类
CCycDB 将其 4,676 个基因家族组织为六个具有生物学意义的顶层分类,这些分类共同涵盖了完整的碳循环。下表总结了每个分类,并从实际输出中提取了示例:
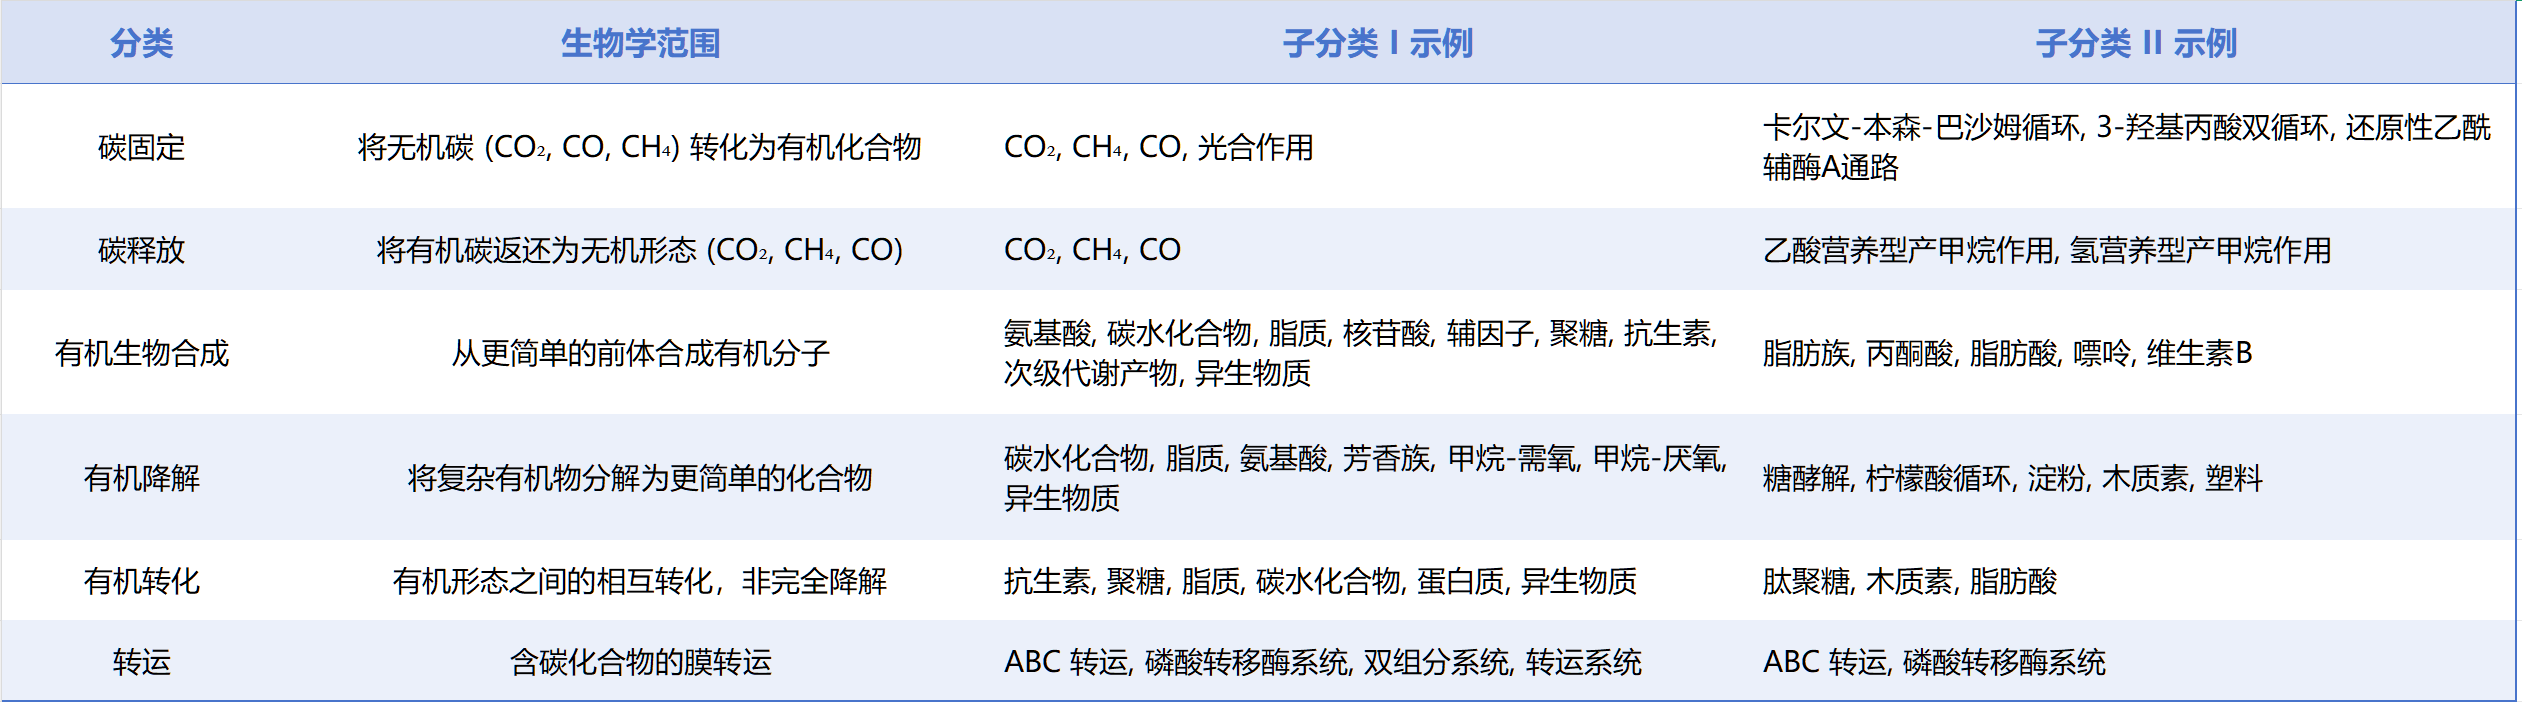
- 4,676 个碳循环基因家族,细分 45 个一级子类、188 个二级子类
- 约 1,099 万条高质量参考序列(整合了 UniProt、BRENDA、KEGG、CAZy/dbCAN2、DRAM 及 NCycDB 等框架)
- 六大功能模块:
- Carbon fixation 碳固定(Calvin 循环、Wood–Ljungdahl、3-HP/4-HB 等,含 cbbLS/rbcL、acsA/B)
- Carbon release 碳释放(甲烷生成 pmoABC、呼吸/发酵产 CO₂ 等)
- Organic biosynthesis 有机物合成(含 DMSP 合成 dsyB/mmtN 等)
- Organic degradation 有机物降解(淀粉、果胶、几丁质、木质素相关 CAZy 酶)
- Organic transformation 有机物转化
- Transporters 转运蛋白(ABC、PTS 等)
输入文件:
基因组/宏基因组预组装结果文件或包含所有待分析基因组的zip压缩包。
小工具结果:
anno_result_full.csv
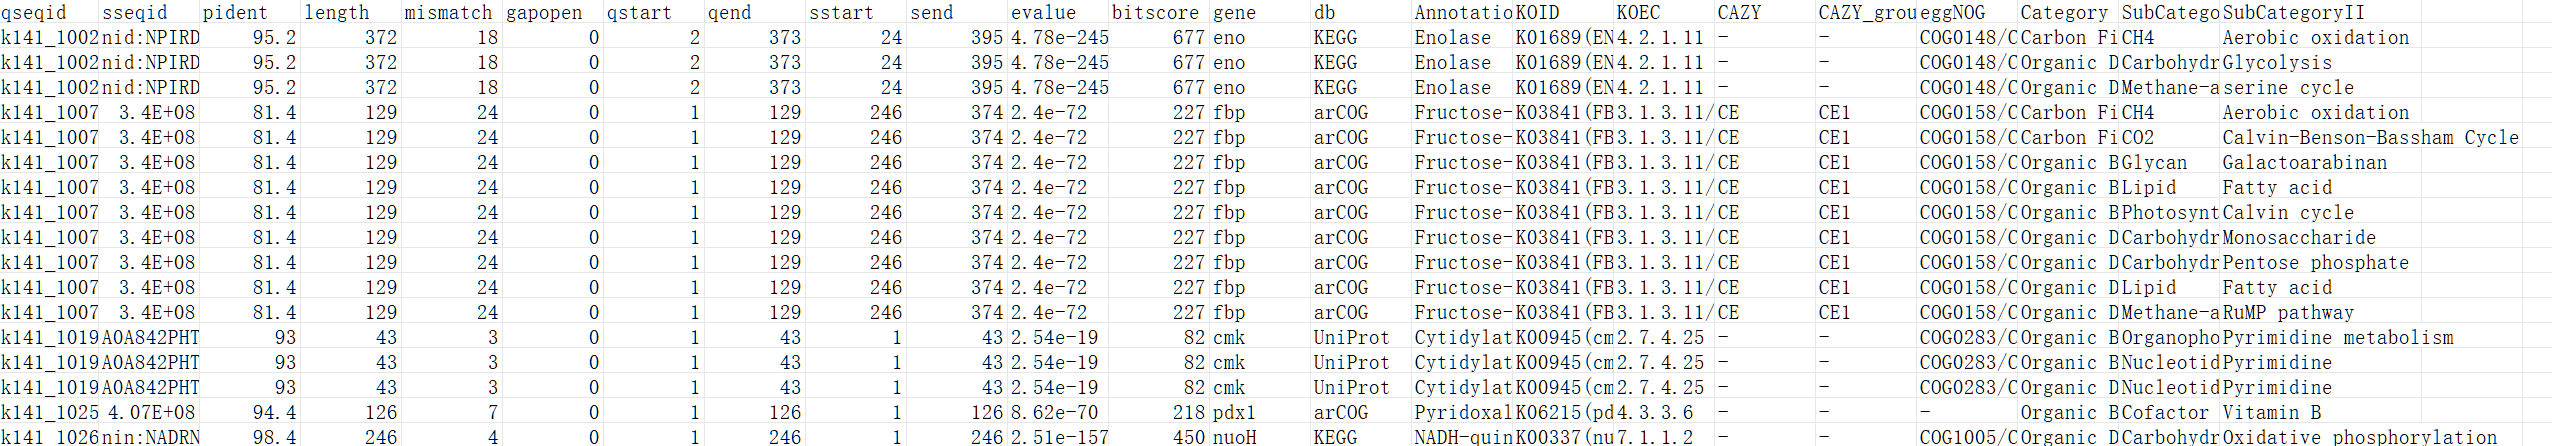
qseqid:Query sequence ID,输入的基因编号(一个基因可以参与多个碳循环过程);sseqid:Subject sequence ID,比对上的 CCycDB 参考序列 ID;pident:一致性百分比(% identity);length:比对长度(对齐的氨基酸/碱基个数);mismatch:错配数;gapopen:gap数;qstart:查询序列比对起始位置;qend:查询序列比对结束位置;sstart:参考序列比对起始位置;send:参考序列比对结束位置;evalue:期望值,越小越显著(通常 < 1e-5 算可靠);bitscore:比特分值,越高代表匹配质量越好;gene:基因简称;db:该注释来源的原始数据库;Annotation:基因功能描述;KOID:KEGG Orthology (KO) 编号 + 基因名 + 功能描述;KOEC:对应的 EC 酶学编号(反应催化类型);CAZY:CAZy 酶分类(GH/GT/CE/PL/CBM 等);CAZY_group:CAZy 亚家族;eggNOG:eggNOG / COG 编号(用 / 分隔多个);Category:一级分类,碳循环六大模块之一;SubCategoryI:二级分类,具体碳循环过程/路径;SubCategoryII:三级分类,更细的亚途径/反应类型。
anno_result.csv
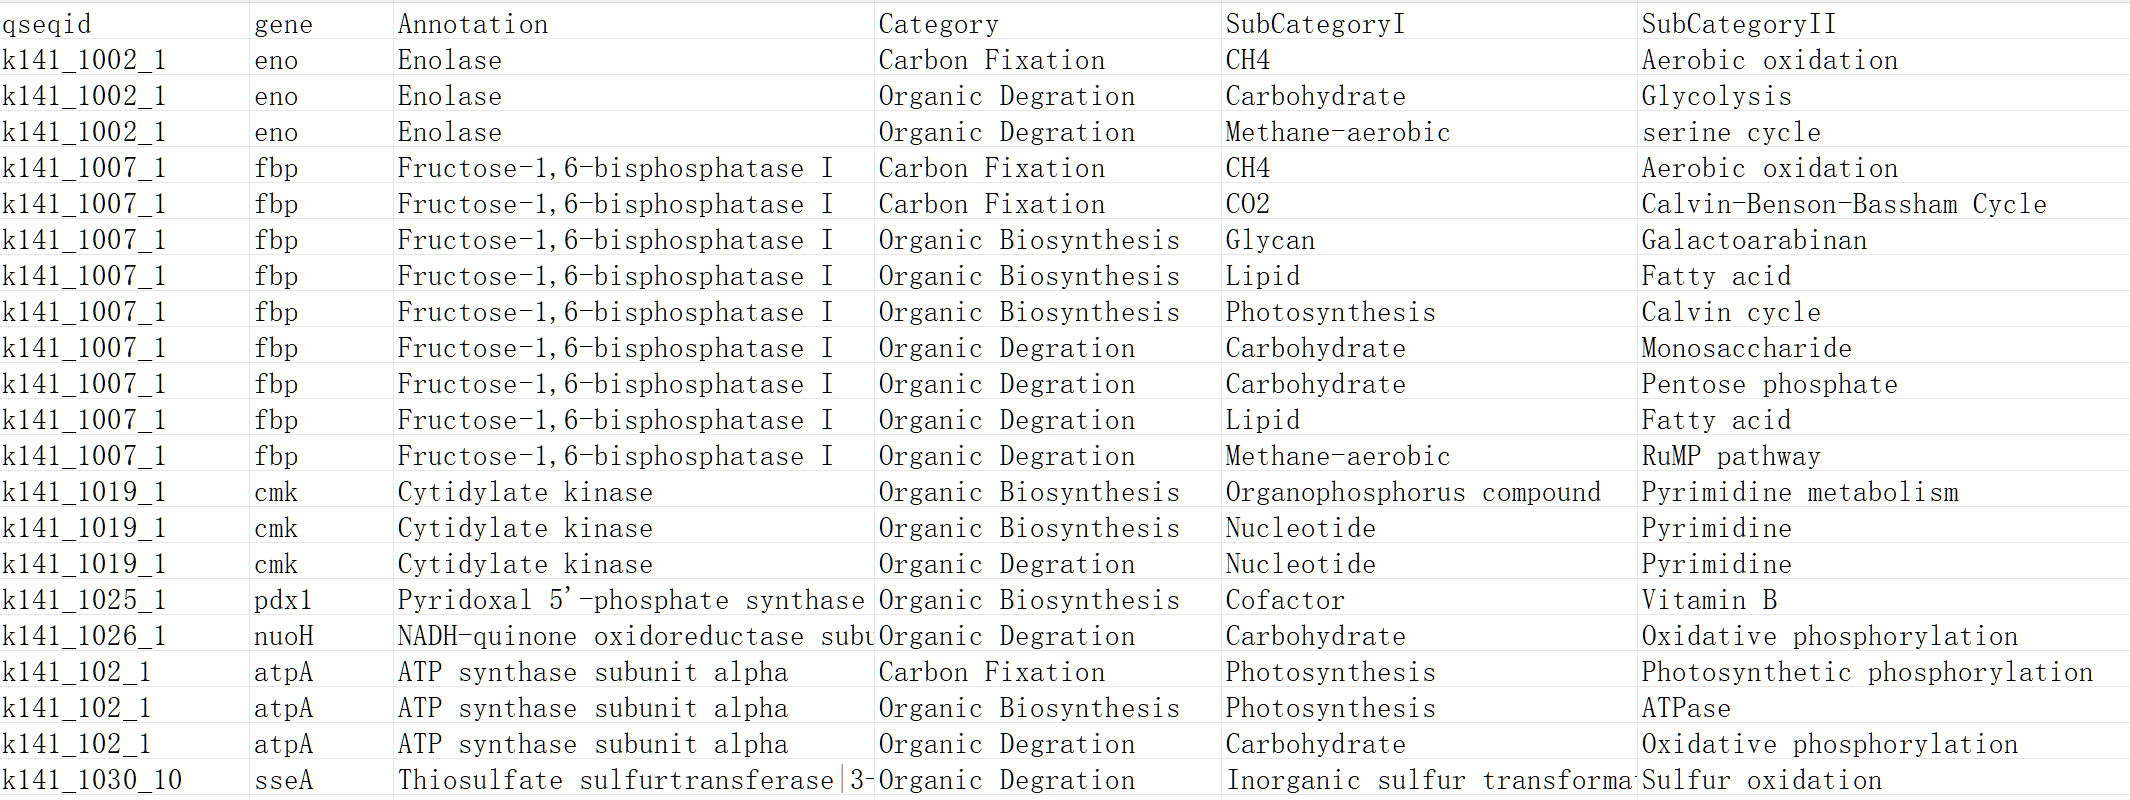
qseqid:Query sequence ID,输入的基因编号(一个基因可以参与多个碳循环过程);gene:基因简称;Annotation:基因功能描述;Category:一级分类,碳循环六大模块之一;SubCategoryI:二级分类,具体碳循环过程/路径;SubCategoryII:三级分类,更细的亚途径/反应类型。
gene_count_pathway.csv
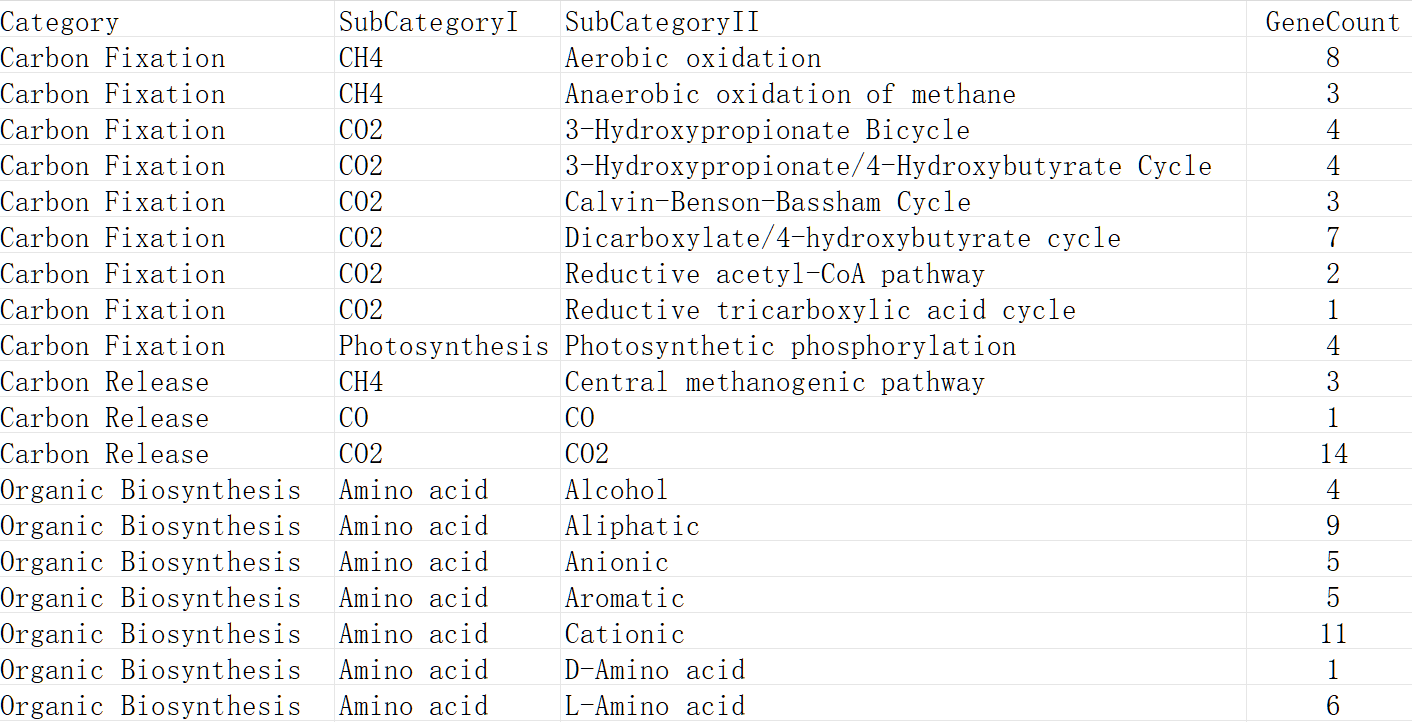
Category:一级分类,碳循环六大模块之一;SubCategoryI:二级分类,具体碳循环过程/路径;SubCategoryII:三级分类,更细的亚途径/反应类型;GeneCount:该三级分类下检测到的基因家族数量(即有多少个不同的碳循环基因/同源群被注释到)。
参考文献:
Jiayin Z, Lu Q, Mengzhi J, et al., CCycDB: an integrative knowledgebase to fingerprint microbial carbon cycling processes. bioRxiv, 2026, DOI: https://doi.org/10.64898/2026.01.28.702190
数据库版本:Version 2.1 (Upadate: Oct. 2025)