- 结果文件
- 使用指南
- 版本记录
- 联系客服
Pharokka 是一款专门为噬菌体(Bacteriophage)基因组设计的快速、可扩展的自动化注释工具。它解决了传统细菌注释工具(如 Prokka)在分析噬菌体时因基因结构差异(如高密度、小基因、非标准起始密码子)导致的准确率低、漏检多的问题。
核心功能
Pharokka 的工作流程高度集成,主要包含以下四个核心模块:
基因预测 (CDS Prediction)
功能注释 (Functional Annotation)
-
核心数据库:PHROGs (Phage Orthologous Groups)。这是一个专门针对噬菌体蛋白构建的数据库,包含 38,880 个蛋白同源群,能提供更精准的功能分类(如结构蛋白、DNA代谢、宿主裂解等)。
辅助数据库:整合了 CARD (抗生素抗性数据库) 和 VFDB (毒力因子数据库),用于筛查噬菌体中可能携带的耐药基因或毒力基因。
非编码元件识别 (Non-coding Elements)
使用 tRNAscan-SE 预测 tRNA,Aragorn 预测 tmRNA,MinCED 预测 CRISPR 序列。
输出与下游兼容 (Output & Compatibility)
生成标准的 GFF3 格式文件,可直接用于下游泛基因组分析工具(如 Roary、Panaroo)。
提供详细的统计报告,包括编码密度、GC含量、功能分类计数等。
主要优势
专一性:针对噬菌体基因组的特殊结构(高密度、小基因、非标准起始密码子)进行了算法优化,注释准确率显著高于通用工具。
速度与可扩展性:支持多线程,对于单个噬菌体基因组(约 50kb)通常能在 5 分钟内完成注释,且支持大规模宏基因组数据的批量处理。
易用性:通过 Conda 或 Docker 一键安装,命令行参数简洁,无需复杂的配置。
适用场景
噬菌体分离株的完整基因组注释。
宏基因组组装病毒组(viral contigs)的功能分析。
噬菌体疗法研究中的基因功能筛查(如抗性基因、毒力基因检测)。
输入文件:
待注释的噬菌体基因组文件(FASTA格式)
小工具结果:
*.gff (标准通用特征格式文件)
*.gbk (GenBank 格式文件)
*.faa (蛋白序列 FASTA 文件)
*.fna (核酸序列 FASTA 文件)
*_cds_final_merged_output.tsv.tsv (主注释结果表格)
pharokka_cds_functions.tsv (CDS 功能分类统计)
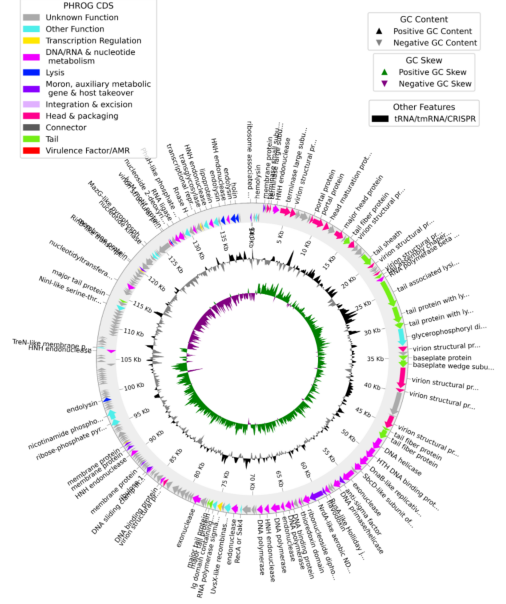
pharokka_plots/*.png&svg:注释结果可视化圈图
软件版本:Pharokka 1.9.1
参考文献:
George Bouras, Roshan Nepal, Ghais Houtak, Alkis James Psaltis, Peter-John Wormald, Sarah Vreugde, Pharokka: a fast scalable bacteriophage annotation tool, Bioinformatics, Volume 39, Issue 1, January 2023, btac776, https://doi.org/10.1093/bioinformatics/btac776